Konfigurationsreferenz
Alles, was pullpress.config.yml versteht: die eine Datei, die Ihr Repo zum CMS macht.
Die Konfigurationsdatei liegt im Stammverzeichnis Ihres Repositorys und ist versioniert wie alles andere. Anders als Inhaltsänderungen (die eine Änderungsanfrage zur Prüfung öffnen) ist das Speichern der Konfiguration eine Administratoraktion, die direkt auf Ihren Standard-Branch committet, damit ein neues Inhaltsmodell sofort greift (und vor dem Schreiben geprüft wird). Sie hat eine Handvoll Schlüssel auf oberster Ebene, eine Liste von Sammlungen und eine kleine Menge Feldtypen.
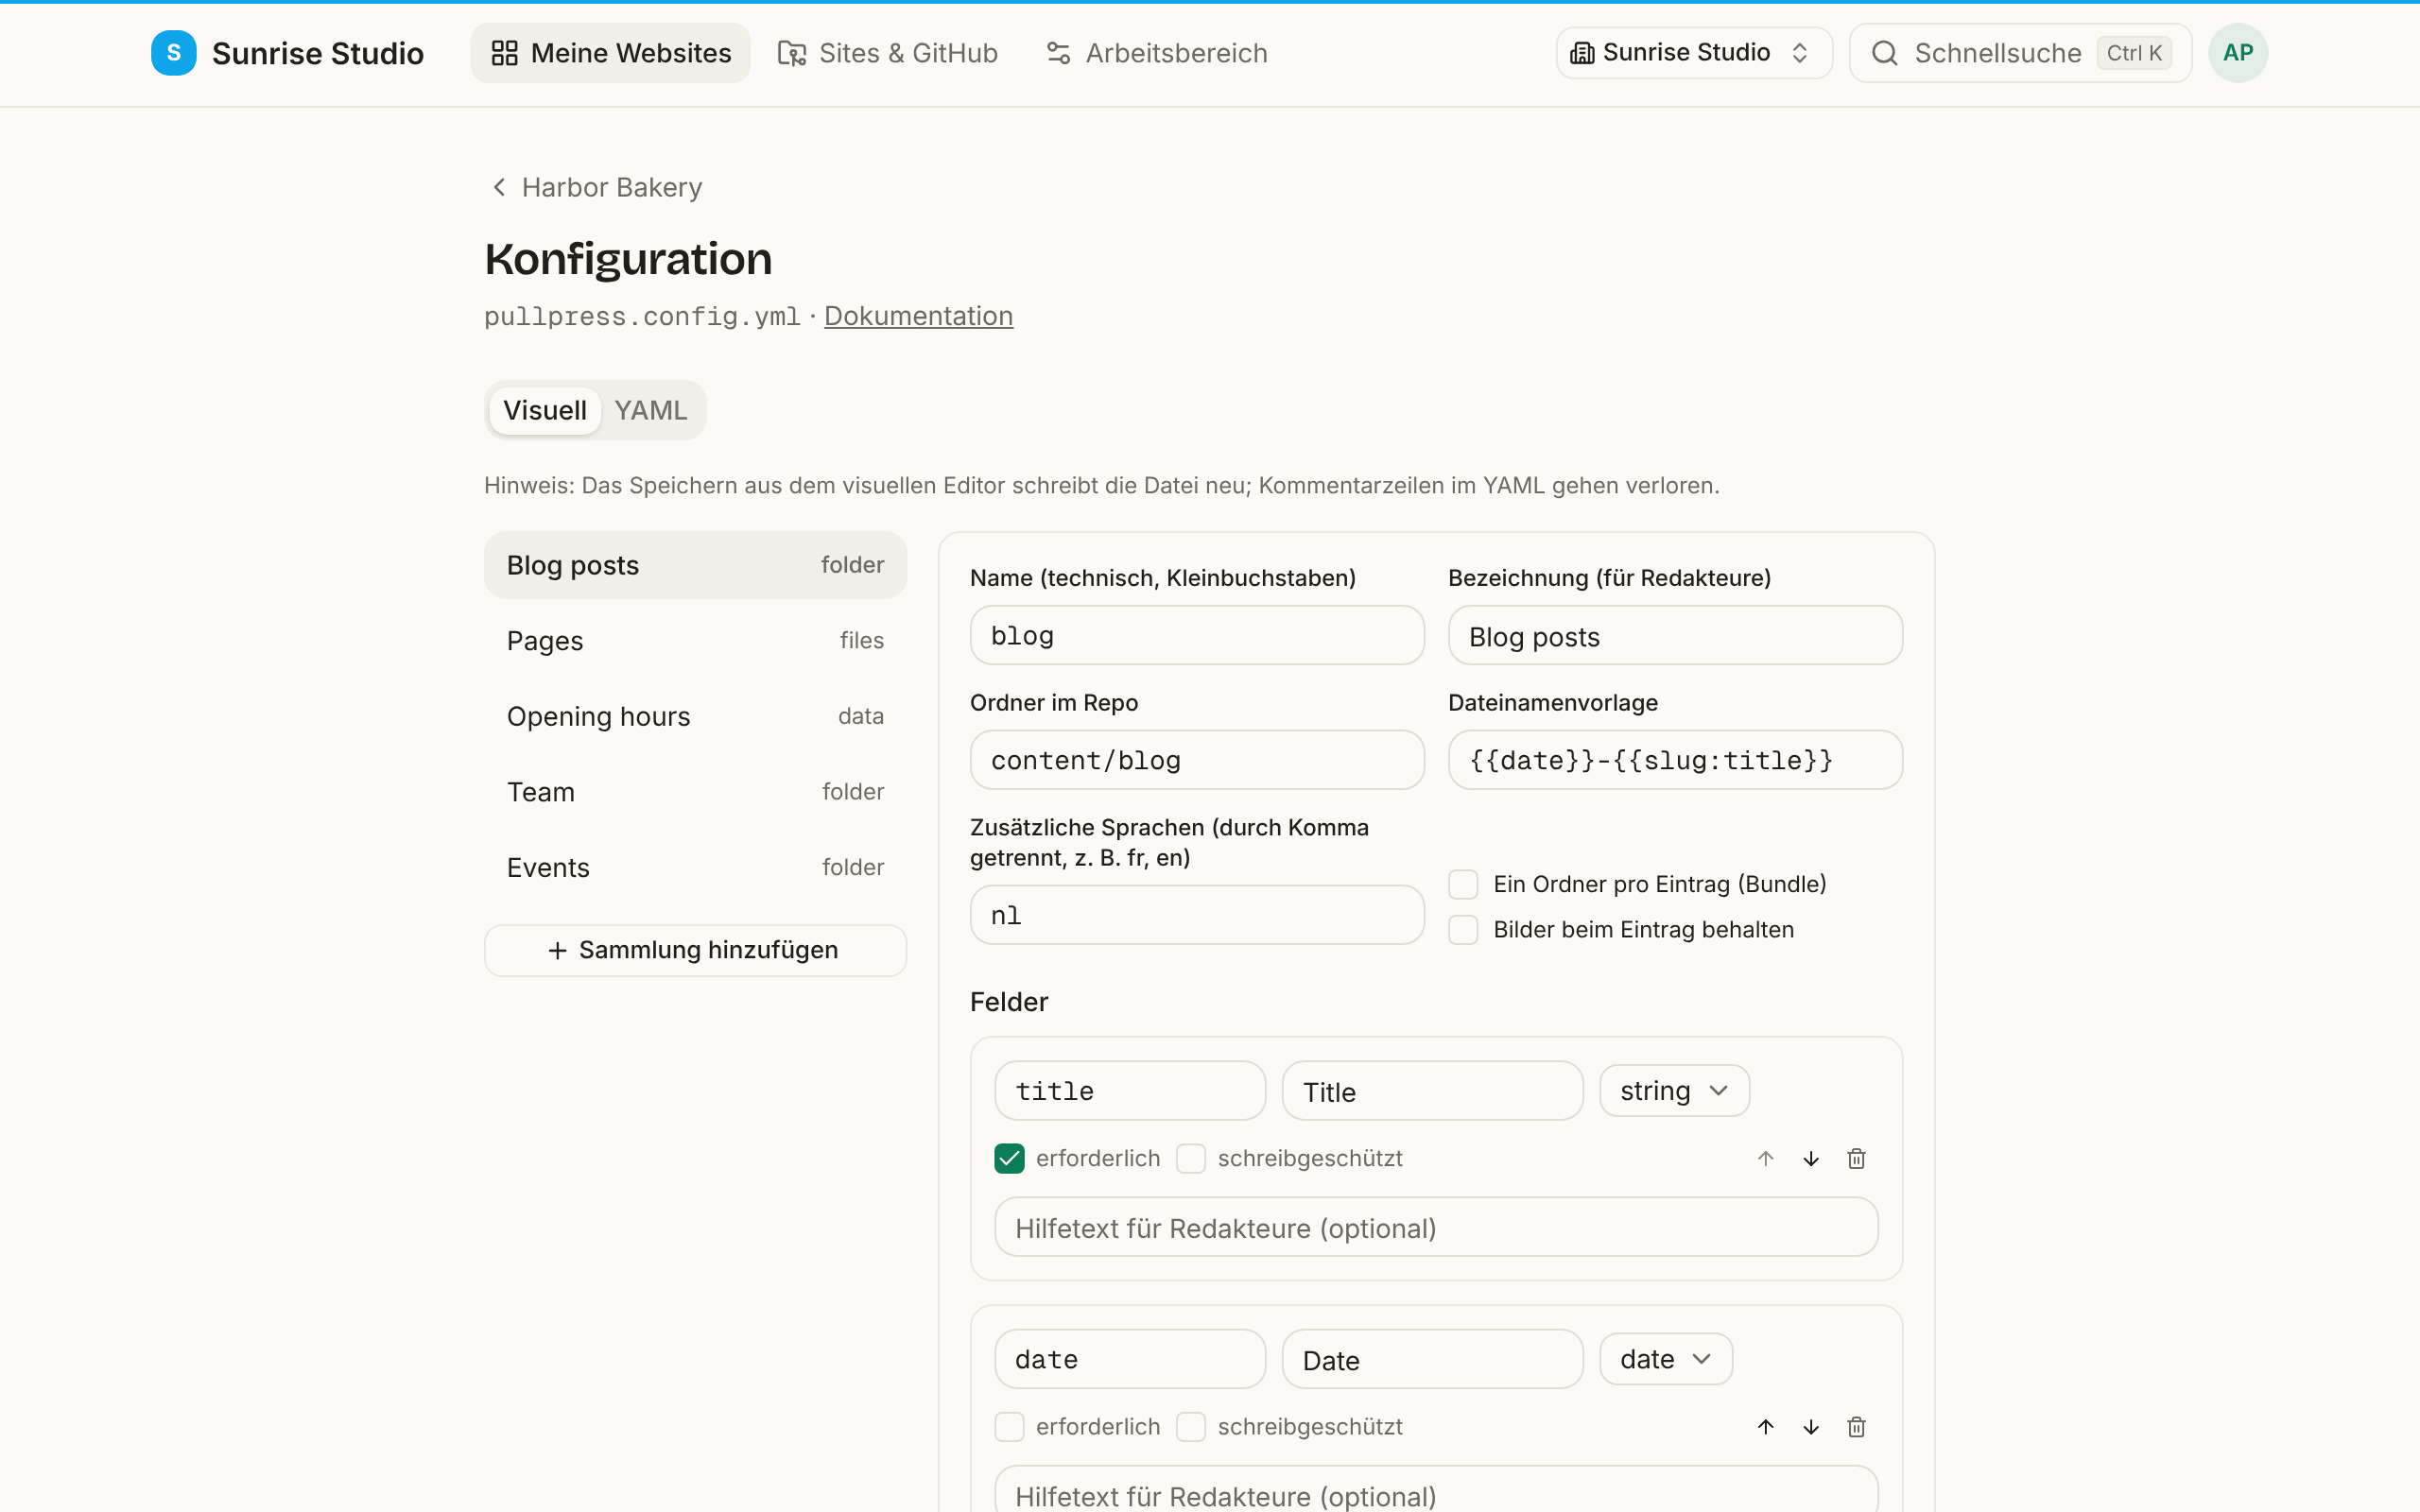
Lieber in der App bearbeiten? Der eingebaute Konfigurationseditor hat einen visuellen Modus, dessen Auswahl der Feldtypen jeden Typ mit einer einzeiligen Beschreibung gruppiert, und sein YAML-Modus prüft vor dem Speichern: Ein Syntaxfehler wird an seiner genauen Zeile und Spalte gezeigt, und strukturelle Probleme werden pro Feldpfad aufgelistet. Der Dateiname ist pullpress.config.yml (die Endung .yaml geht auch).
Schlüssel auf oberster Ebene
| Schlüssel | Beschreibung |
|---|---|
version | Version des Konfigurationsschemas. Derzeit immer 1. |
media.folder | Pfad im Repository, in den hochgeladene Bilder committet werden, z. B. public/uploads. |
media.public_path | URL-Präfix, unter dem die veröffentlichte Site diesen Ordner ausliefert, z. B. /uploads. Dient dazu, korrekte Bildlinks in Ihr Markdown zu schreiben. |
collections | Die Liste der Inhaltssammlungen, mit denen Redakteure arbeiten. Jede Sammlung hat einen Namen, eine Beschriftung, einen Typ und Felder. |
components | Optional. Eine Zuordnung wiederverwendbarer, benannter Feldgruppen, auf die Felder mit type: component verweisen. Einmal definieren, in mehreren Sammlungen wiederverwenden. |
Sammlungstypen
Eine Sammlung beschreibt eine Art von Inhalt. Ihr type entscheidet, wie Einträge auf Dateien im Repository abgebildet werden.
folder: eine Datei pro Eintrag
Jeder Eintrag ist eine eigene Markdown-Datei im eingestellten Ordner. Redakteure können Einträge anlegen, bearbeiten und löschen: ideal für Blogbeiträge, Neuigkeiten oder Teammitglieder.
collections:
  - name: blog
    label: Blog posts
    type: folder
    folder: content/blog
    fields:
      - { name: title, label: Title, type: string, required: true }
      - { name: date,  label: Date,  type: date, default: now }
      - { name: body,  label: Body,  type: markdown }
Frontmatter-Formate. Alle drei Formate bleiben erhalten: YAML zwischen Zeilen ---, TOML zwischen Zeilen +++ (der Standard von Hugo) und ein bloßes JSON-Objekt am Anfang der Datei. Bestehende Einträge behalten immer ihr Format, die Reihenfolge der Schlüssel und Schlüssel, die PullPress nicht verwaltet. YAML-Frontmatter behält beim Speichern auch seine # comments, Anker und Blockstrings mit |/>: Das Bearbeiten eines Felds ergibt einen Diff, der nur dieses Feld berührt. (TOML- und JSON-Frontmatter behalten Werte und Reihenfolge der Schlüssel, Kommentarzeilen in TOML bleiben aber nicht erhalten.) Setzen Sie format: toml (oder json) auf eine Sammlung, um neue Einträge in diesem Format anzulegen; die Erkennung trägt das für Sie ein, wenn Ihre bestehenden Inhalte es nutzen.
Sites mit einem Ordner pro Eintrag (Astro content collections, Hugo Leaf Bundles: content/my-post/index.md) setzen structure: bundle. Fügen Sie media: colocated hinzu, um die Bilder eines Eintrags in dessen eigenem Ordner abzulegen, relativ referenziert (./photo.jpg), damit die Bildpipeline Ihres Generators sie aufgreift. Die Erkennung des Repositorys schlägt Ihnen das alles vor: Sie kennt Astro content collections, Hugo Leaf und Branch Bundles (plus contentDir und Dateien in data/), Jekyll-Sammlungen aus _config.yml, Next.js-Inhaltsordner und nach Datum verschachtelte Bundles, und schreibt die erzeugten Beschriftungen in der Sprache Ihrer Oberfläche:
collections:
  - name: projects
    label: Projects
    type: folder
    folder: redesign/content
    structure: bundle      # one folder per entry: content/my-post/index.md
    media: colocated       # images live inside the entry folder (./photo.jpg)
    slug: "{{date}}-{{slug:title}}"
    fields:
      - { name: title, label: Title, type: string, required: true }
      - { name: date,  label: Date,  type: date, default: now }
- { name: body, label: Body, type: markdown }files: feste Seiten
Eine feste Menge von Dateien, die Sie ausdrücklich auflisten. Redakteure können sie bearbeiten, aber keine hinzufügen oder entfernen: richtig für einzelne Seiten wie Über uns oder Kontakt. Jede Datei hat ihre eigenen fields (verschachtelt unter dieser Datei, nicht auf Sammlungsebene geteilt), sodass jede Seite eine andere Form haben kann.
collections:
  - name: pages
    label: Pages
    type: files
    files:
      - name: about
        label: About page
        file: content/about.md
        fields:
          - { name: title, label: Title, type: string, required: true }
          - { name: body,  label: Body,  type: markdown }
      - name: contact
        label: Contact page
        file: content/contact.md
        fields:
          - { name: heading, label: Heading, type: string, required: true }
          - { name: body,    label: Body,    type: markdown }
Die Erkennung nutzt das auch für Abschnittsseiten: Die _index.md eines Hugo Branch Bundles (die Einstiegsseite eines Abschnitts) ist kein Eintrag der folder-Sammlung, daher sammelt die Erkennung alle gefundenen in einer erzeugten files-Sammlung „Section pages“, bearbeitbar wie jede andere Seite, ohne Handarbeit.
data: eine einzelne strukturierte Datendatei
Eine YAML-, JSON- oder TOML-Datei, die ganz über ein Formular bearbeitet wird, ohne Markdown-Body. Nutzen Sie sie für strukturierte Daten, die Ihre Templates direkt lesen: Öffnungszeiten, Navigationsmenüs, Site-Einstellungen. Schlüssel in der Datei, die nicht in der Feldkonfiguration stehen, überstehen jedes Speichern, in allen drei Formaten. YAML-Dateien behalten auch ihre Kommentare; TOML- und JSON-Dateien behalten Schlüssel und Reihenfolge, werden aber neu formatiert.
collections:
  - name: opening_hours
    label: Opening hours
    type: data
    file: data/opening-hours.yml
    fields:
      - name: hours
        label: Weekly hours
        type: list
        of:
          type: object
          fields:
            - { name: day,    label: Day,    type: select, options: [mon, tue, wed, thu, fri, sat, sun] }
            - { name: open,   label: Opens,  type: string }
            - { name: close,  label: Closes, type: string }
            - { name: closed, label: Closed all day, type: boolean, default: false }
Manche Datendateien sind keine Zuordnung, sondern eine große Liste: ein Array am Anfang der Datei, wie es der Loader file() von Astro liest (src/data/authors.json mit [ …, … ]), oder Listen-Datendateien von Hugo/Jekyll/Eleventy. Setzen Sie root: list und deklarieren Sie genau ein Feld vom Typ list: Seine Elemente sind das Array der obersten Ebene, bearbeitet als wiederholbares Formular. Elemente, die Sie nicht anfassen, werden unverändert zurückgeschrieben (Reihenfolge ihrer Schlüssel und zusätzliche Schlüssel bleiben erhalten); TOML kann kein Array auf oberster Ebene darstellen, daher funktioniert das für Dateien .json, .yaml und .yml. Die Erkennung schlägt diese Form automatisch vor.
CSV- und TSV-Dateien (Jekyll _data/*.csv, Exporte aus Tabellen) funktionieren genauso: Sie sind immer tabellarisch, also lassen Sie eine data-Sammlung mit root: list auf die Datei zeigen und listen die Spalten als string-Felder des einzigen Felds list auf. Kopfzeile und Spaltenreihenfolge bleiben beim Speichern erhalten; jeder Wert geht als Text hin und zurück.
collections:
  - name: authors
    label: Authors
    type: data
    file: src/data/authors.json   # the file's root is [ … ], not { … }
    root: list
    fields:                       # exactly one field, of type list
      - name: items
        label: Authors
        type: list
        of:
          type: object
          fields:
            - { name: name,   label: Name,   type: string, required: true }
            - { name: avatar, label: Avatar, type: image }
folder mit Dateneinträgen: ohne Markdown-Body
Manchmal ist jeder Eintrag reine strukturierte Daten ohne Artikeltext: Autoren, Teammitglieder, Produkte, Linklisten. Geben Sie einer folder-Sammlung eine Daten-extension (json, yaml, yml oder toml), und jeder Eintrag wird eine einzelne Datendatei, die Redakteure als Formular ausfüllen: dasselbe Anlegen, Bearbeiten, Löschen, Prüfen und derselbe Verlauf wie bei Markdown, nur ohne Body. Genau so funktionieren Astro-Sammlungen mit type: 'data', und die Erkennung schlägt sie Ihnen vor.
collections:
  - name: authors
    label: Authors
    type: folder
    folder: src/content/authors
    extension: json          # each entry is a .json data file (no body)
    slug: "{{slug:name}}"
    fields:
      - { name: name,   label: Name,   type: string, required: true }
      - { name: bio,    label: Bio,    type: text }
      - { name: avatar, label: Avatar, type: image }
Die ganze Datei sind die Daten (ihr Format folgt der Endung), und wie bei einer data-Sammlung bleiben die Reihenfolge der Schlüssel und Schlüssel, die nicht in Ihrer Feldliste stehen, bei jedem Speichern erhalten. Es gibt kein Body-Feld, fügen Sie also keines hinzu; Relationen können auch auf diese Sammlungen zeigen.
Sammlungsoptionen
Neben name, label, folder und fields nimmt eine folder-Sammlung diese optionalen Schlüssel. Die Erkennung trägt die meisten für Sie ein.
| Schlüssel | Beschreibung |
|---|---|
structure | flat (Standard) hält eine Datei pro Eintrag; bundle nutzt einen Ordner pro Eintrag (folder/slug/index.md). |
media | site (Standard) schickt Uploads in den Medienordner; colocated legt sie im eigenen Bundle-Ordner des Eintrags ab, referenziert als ./photo.jpg. colocated verlangt structure: bundle. |
extension | Dateityp der Einträge: md (Standard), markdown oder mdx für Markdown-Seiten; html, adoc oder org für Inhalte ohne Markdown (das Frontmatter bleibt erhalten; deklarieren Sie den Body als type: code, damit er als einfacher Text bearbeitet wird); oder json, yaml, yml oder toml, um jeden Eintrag zu einer Datendatei ohne Body zu machen (ein Ordner mit Dateneinträgen, wie Astro data collections). |
format | Frontmatter-Format für neue Einträge: yaml (Standard), toml oder json. Bestehende Einträge behalten ihr Format. |
nested | true sammelt auch Einträge aus Unterordnern (bis zu fünf Ebenen tief), gruppiert nach Ordner. Standardmäßig aus. |
locales | Zusätzliche Sprachcodes (z. B. [fr, en]), die jeden Eintrag pro Sprache bearbeitbar machen, angeordnet nach dem Schlüssel i18n. |
i18n | Wo Übersetzungen liegen: suffix (Standard) nutzt Geschwisterdateien (post.fr.md); subfolder nutzt einen Ordner pro Sprache (Hugo content/<lang>/, Astro/Starlight docs/<lang>/). Mit subfolder zeigt folder auf den Ordner der Standardsprache, und defaultLocale nennt dieses Segment; z. B. legt folder: content/en, defaultLocale: en, locales: [fr, de] französische Einträge in content/fr ab. |
slug | Vorlage für den Dateinamen neuer Einträge. Standard {{slug:title}}. Tokens: {{slug:field}} (Feld als Slug), {{field}}, {{date}}, {{year}}, {{month}}, {{day}}. |
sort | Wie die Eintragsliste sortiert ist: { field, order } mit order asc oder desc. Standard ist das Datumsfeld, neueste zuerst. |
Eine files-Sammlung listet stattdessen jede Datei mit eigenen fields auf (und einem optionalen format pro Datei); eine data-Sammlung zeigt auf eine einzige file und teilt einen Satz fields.
Feldtypen
Jedes Feld einer Sammlung wird im Editor zu einem Formularelement. Die gemeinsamen Optionen label, required und default funktionieren bei jedem Typ. Zwei weitere helfen Ihren Redakteuren: ein Text in help zeigt einen Hinweis unter dem Feld, und ein placeholder zeigt Beispieltext in einem leeren Eingabefeld. Pflichtfelder bekommen ein rotes Sternchen und beim Einreichen eine freundliche Übersicht, was fehlt.
Schreibgeschützte Felder. Fügen Sie readOnly: true hinzu, um ein Feld mit seinem gespeicherten Wert anzuzeigen, ohne dass Redakteure es ändern können: der Name eines Einstellungsdokuments, ein gesperrter Slug, eine externe ID. Es ist im Web-Editor wie in der iOS-App gesperrt, und der Server stellt bei jedem Speichern den gespeicherten Wert wieder her, sodass ein schreibgeschütztes Feld nie abweichen kann, egal wie eine Änderung hereinkommt.
- name: title
  type: string
  label: Name
  readOnly: true            # shown, but editors can't change it
Text pro Sprache. Die Oberfläche passt sich der gewählten Sprache jedes Redakteurs an, und dasselbe können Sie für Ihre eigenen Texte in label, help und placeholder tun. Den bloßen Schlüssel sehen alle; fügen Sie ein Suffix _<language> hinzu (eines von en, nl, fr, de, es), um ihn für Redakteure mit dieser Sprache zu ersetzen. Nichts wird automatisch übersetzt: Sie schreiben jede Variante selbst.
- name: title
  type: string
  label: Titel              # shown to everyone
  help: De titel van je pagina
help_en: Your page title # only for editors using English| Typ | Beschreibung | Beispiel |
|---|---|---|
string | Eine einzelne Textzeile. | { name: title, type: string, required: true } |
text | Mehrzeiliger einfacher Text, als Textbereich angezeigt. | { name: summary, type: text } |
markdown | Formatierter Text im aufgeräumten Editor, gespeichert als Markdown. | { name: body, type: markdown } |
number | Eine Ganz- oder Dezimalzahl. | { name: price, type: number } |
boolean | Ein Ja/Nein-Schalter. | { name: featured, type: boolean, default: false } |
date | Ein Kalenderdatum. default: now trägt das heutige Datum ein. | { name: date, type: date, default: now } |
datetime | Ein Datum mit Uhrzeit. | { name: published_at, type: datetime } |
select | Eine Auswahl aus einer festen Liste, über options. | { name: category, type: select, options: [news, recipes] } |
multiselect | Mehrere Auswahlen aus einer festen Liste, als Kontrollkästchen. | { name: categories, type: multiselect, options: [news, events] } |
url | Eine Webadresse, geprüft als https://… | { name: website, type: url } |
email | Eine geprüfte E-Mail-Adresse. | { name: contact, type: email } |
color | Eine Farbauswahl, gespeichert als #rrggbb. | { name: accent, type: color } |
image | Ein hochgeladenes Bild, in den Medienordner committet. | { name: cover, type: image } |
list | Eine wiederholbare Liste von Elementen; of ist die Felddefinition für den Elementtyp. | { name: tags, type: list, of: { type: string } } |
object | Eine Gruppe verschachtelter Felder, definiert mit fields. | { name: cta, type: object, fields: [...] } |
relation | Ein Verweis auf einen Eintrag einer anderen folder-Sammlung (speichert dessen Slug). | { name: author, type: relation, collection: team } |
blocks | Stapelbare Abschnitte unterschiedlicher Form (jedes Element trägt einen Schlüssel _type; mit typeKey überschreibbar). | { name: sections, type: blocks, blocks: [...] } |
hidden | Für Redakteure unsichtbar; wird mit einem festen Wert mitgeschrieben (z. B. ein Layout-Schlüssel). | { name: layout, type: hidden, default: post } |
code | Ein Codeblock in Festbreitenschrift, mit optionalem Sprachhinweis. | { name: snippet, type: code, language: js } |
map | Ein Ort, bearbeitet als Breiten- und Längengrad (gespeichert als 'lat,lng'). | { name: location, type: map } |
compute | Ein schreibgeschützter Wert aus einer Vorlage; jedes {{token}} ist der Name eines Nachbarfelds. | { name: ref, type: compute, template: '{{brand}}-{{sku}}' } |
keyvalue | Beliebige Schlüssel/Wert-Paare, z. B. zusätzliche Metadaten. | { name: meta, type: keyvalue } |
seo | SEO-Bereich: Titel + Beschreibung (mit Längenhinweisen), kanonische URL, OG-Bild und noindex, mit Vorschau des Suchergebnisses und des JSON-LD. | { name: seo, type: seo } |
component | Setzt eine wiederverwendbare Feldgruppe aus der Zuordnung components auf oberster Ebene ein. | { name: cta, type: component, component: callToAction } |
list und object lassen sich kombinieren: Eine list aus object ergibt wiederholbare Feldgruppen, wie die wöchentlichen Öffnungszeiten im Beispiel oben.
Validierungsregeln
Neben required kann ein Feld genau die Einschränkungen übernehmen, die das Schema Ihres Generators durchsetzt, damit Fehler im Editor mit einer freundlichen Meldung auffallen und nicht erst durch einen fehlschlagenden Build. Zahlenfelder nehmen min, max und integer: true; Textfelder (string, text, markdown, code) nehmen minLength, maxLength und einen regulären Ausdruck in pattern; list und multiselect nehmen minItems und maxItems. Verstöße erscheinen beim Schreiben direkt am Feld (ein optionales Feld darf leer bleiben; seine Regeln gelten, sobald etwas eingetippt ist), und dieselben Regeln laufen bei jedem Speichern auf dem Server.
- { name: title,  type: string, required: true, maxLength: 70 }
- { name: rating, type: number, min: 1, max: 5, integer: true }
- { name: sku,    type: string, pattern: "^[A-Z]{2}-\\d{4}$" }
- { name: tags,   type: list, of: { type: string }, minItems: 1, maxItems: 8 }
blocks definieren
Mit einem Feld blocks stapeln Redakteure Abschnitte unterschiedlicher Form (ein Hero, ein Zitat, eine Galerie…). Listen Sie die Abschnittstypen unter blocks auf; jeder ist eine benannte Gruppe von fields (mit optionalem label), genau wie ein object:
- name: sections
  label: Page sections
  type: blocks
  blocks:
    - name: hero
      label: Hero
      fields:
        - { name: heading, type: string, required: true }
        - { name: image,   type: image }
    - name: quote
      label: Pull quote
      fields:
        - { name: text,   type: text, required: true }
        - { name: source, type: string }
Jedes Element, das ein Redakteur hinzufügt, hält unter einem Schlüssel _type fest, welcher Block es ist (hero, quote, …), damit Ihr Generator weiß, wie er jeden Abschnitt darstellt. Erwartet Ihr Schema einen anderen Schlüssel (Astros z.discriminatedUnion('type', …), oder aus Decap CMS importierte Inhalte, die ihn als type speichern), setzen Sie typeKey auf das Feld (typeKey: type), und PullPress liest, schreibt und prüft stattdessen diesen Schlüssel. Der Decap-Import setzt das automatisch, sodass importierte Einträge unverändert funktionieren.
Bedingte Felder (showIf)
Jedes Feld kann showIf deklarieren, um nur zu erscheinen, wenn ein Nachbarfeld passt. Ausgeblendete Felder werden geleert (sie landen also nie im Frontmatter), und die Regel required eines bedingten Felds gilt nur, solange es sichtbar ist.
fields:
  - { name: hasCta, label: Add a call to action?, type: boolean }
  - name: ctaUrl
    label: Button URL
    type: url
    required: true
    showIf: { field: hasCta, truthy: true }   # equals / oneOf also work
Verschachtelte Sammlungen
Setzen Sie nested: true auf eine folder-Sammlung, um auch Einträge aus Unterordnern zu sammeln (bis zu fünf Ebenen tief) und sie nach Ordner gruppiert anzuzeigen: praktisch für Dokumentationsbäume. Suche und Auswahl für Relationen greifen die verschachtelten Einträge automatisch auf.
collections:
  - name: docs
    label: Documentation
    type: folder
    folder: content/docs
    nested: true            # gather entries from subfolders too
    fields:
      - { name: title, type: string, required: true }
      - { name: body,  type: markdown }
Wiederverwendbare Feldkomponenten
Definieren Sie eine benannte Feldgruppe einmal unter der Zuordnung components auf oberster Ebene und setzen Sie sie mit einem Feld component in jede Sammlung ein. Beim Laden wird sie zu einer normalen Objektgruppe, eine Änderung an der Gruppe aktualisiert also jede Sammlung, die sie nutzt.
components:
  callToAction:
    - { name: label, type: string }
    - { name: url,   type: url }
collections:
  - name: pages
    type: folder
    folder: content/pages
    fields:
      - { name: title, type: string, required: true }
      - { name: cta,   type: component, component: callToAction }
Wo Medien liegen (und warum nicht in S3)
Uploads werden in Ihr Repository committet, neben die Inhalte, die auf sie verweisen. Das ist eine bewusste Entscheidung, keine fehlende Funktion: Das Repo bleibt die einzige Quelle der Wahrheit, Bilder reisen mit ihren Beiträgen durch Branches, Prüfung und Verlauf, und wer das Repo klont, hat die komplette Site, ohne zweites System, das gesichert oder bezahlt werden muss.
Brauchen Sie ein CDN oder Bildverkleinerung? Überlassen Sie das beim Build Ihrem Generator oder Hoster (die Bildpipelines von Astro und Next.js, das Image CDN von Netlify, Fetch-URLs von Cloudinary). PullPress hält das Original in Git; Ihr Build macht es schnell. Uploads werden vor dem Senden im Browser auf Webgröße verkleinert, selbst ein Handyfoto von 20–50 MB, was Repos in der Praxis bequem klein hält. Externer Objektspeicher (S3 und Co.) würde die Garantie „Ihr Repo ist alles“ brechen, daher planen wir ihn nicht.
KI-Auffindbarkeit (llms.txt)
PullPress kann eine llms.txt im Stammverzeichnis Ihres Repositorys erzeugen: einen Index Ihrer Site in einfachem Text (Name, URL und pro folder-Sammlung eine Liste der Eintragstitel), den KI-Antwortmaschinen lesen, um Ihre Site korrekt zusammenzufassen und zu zitieren. Er wird deterministisch aus Ihrem Inhaltsmodell gebaut (kein KI-Aufruf, nichts verlässt Ihr Repo).
Administratoren finden das im Bereich Einstellungen → KI-Auffindbarkeit (GEO) einer Site, der auch eine Bereitschaftspunktzahl zeigt: ob Ihre Site-URL gesetzt ist, ob llms.txt vorhanden ist, ob Sie veröffentlichte Inhalte und Felder für Beschreibung/SEO haben und, falls Ihre Site-URL erreichbar ist, ob die Startseite eine Meta Description, Open-Graph-Tags und JSON-LD liefert. Klicken Sie auf llms.txt aktualisieren, um die Datei (neu) zu erzeugen; sie wird committet wie jede andere Änderung: über die Prüfung, oder bei Sites mit direkter Veröffentlichung direkt auf Ihren Standard-Branch.
brandvoice.md unten: Die Markenstimme lenkt, wie die KI für Sie schreibt, während llms.txt der KI hilft, das bereits Veröffentlichte zu finden und zu zitieren. Es verwaltet weder robots.txt noch Ihre Sitemap; die überlassen Sie Ihrem Generator.Markenstimme für KI-Agenten
Legen Sie optional eine brandvoice.md in das Stammverzeichnis Ihres Repositorys, um Ton der Site, bevorzugte und verbotene Wörter und Schreibniveau zu beschreiben. Per MCP verbundene KI-Agenten können sie lesen (über das Tool get_style_guide) und beim Entwerfen befolgen. Weil sie eine normale Datei in Ihrem Repo ist, ist sie versioniert und prüfbar wie jeder andere Inhalt, und für jeden Kunden eigen.